
Quem decide o futuro da inteligência artificial no Sul Global
Do Rio Negro a Macau, o que uma sala de aula na Amazônia revela sobre colonialismo digital e o direito de decidir como a tecnologia é feita
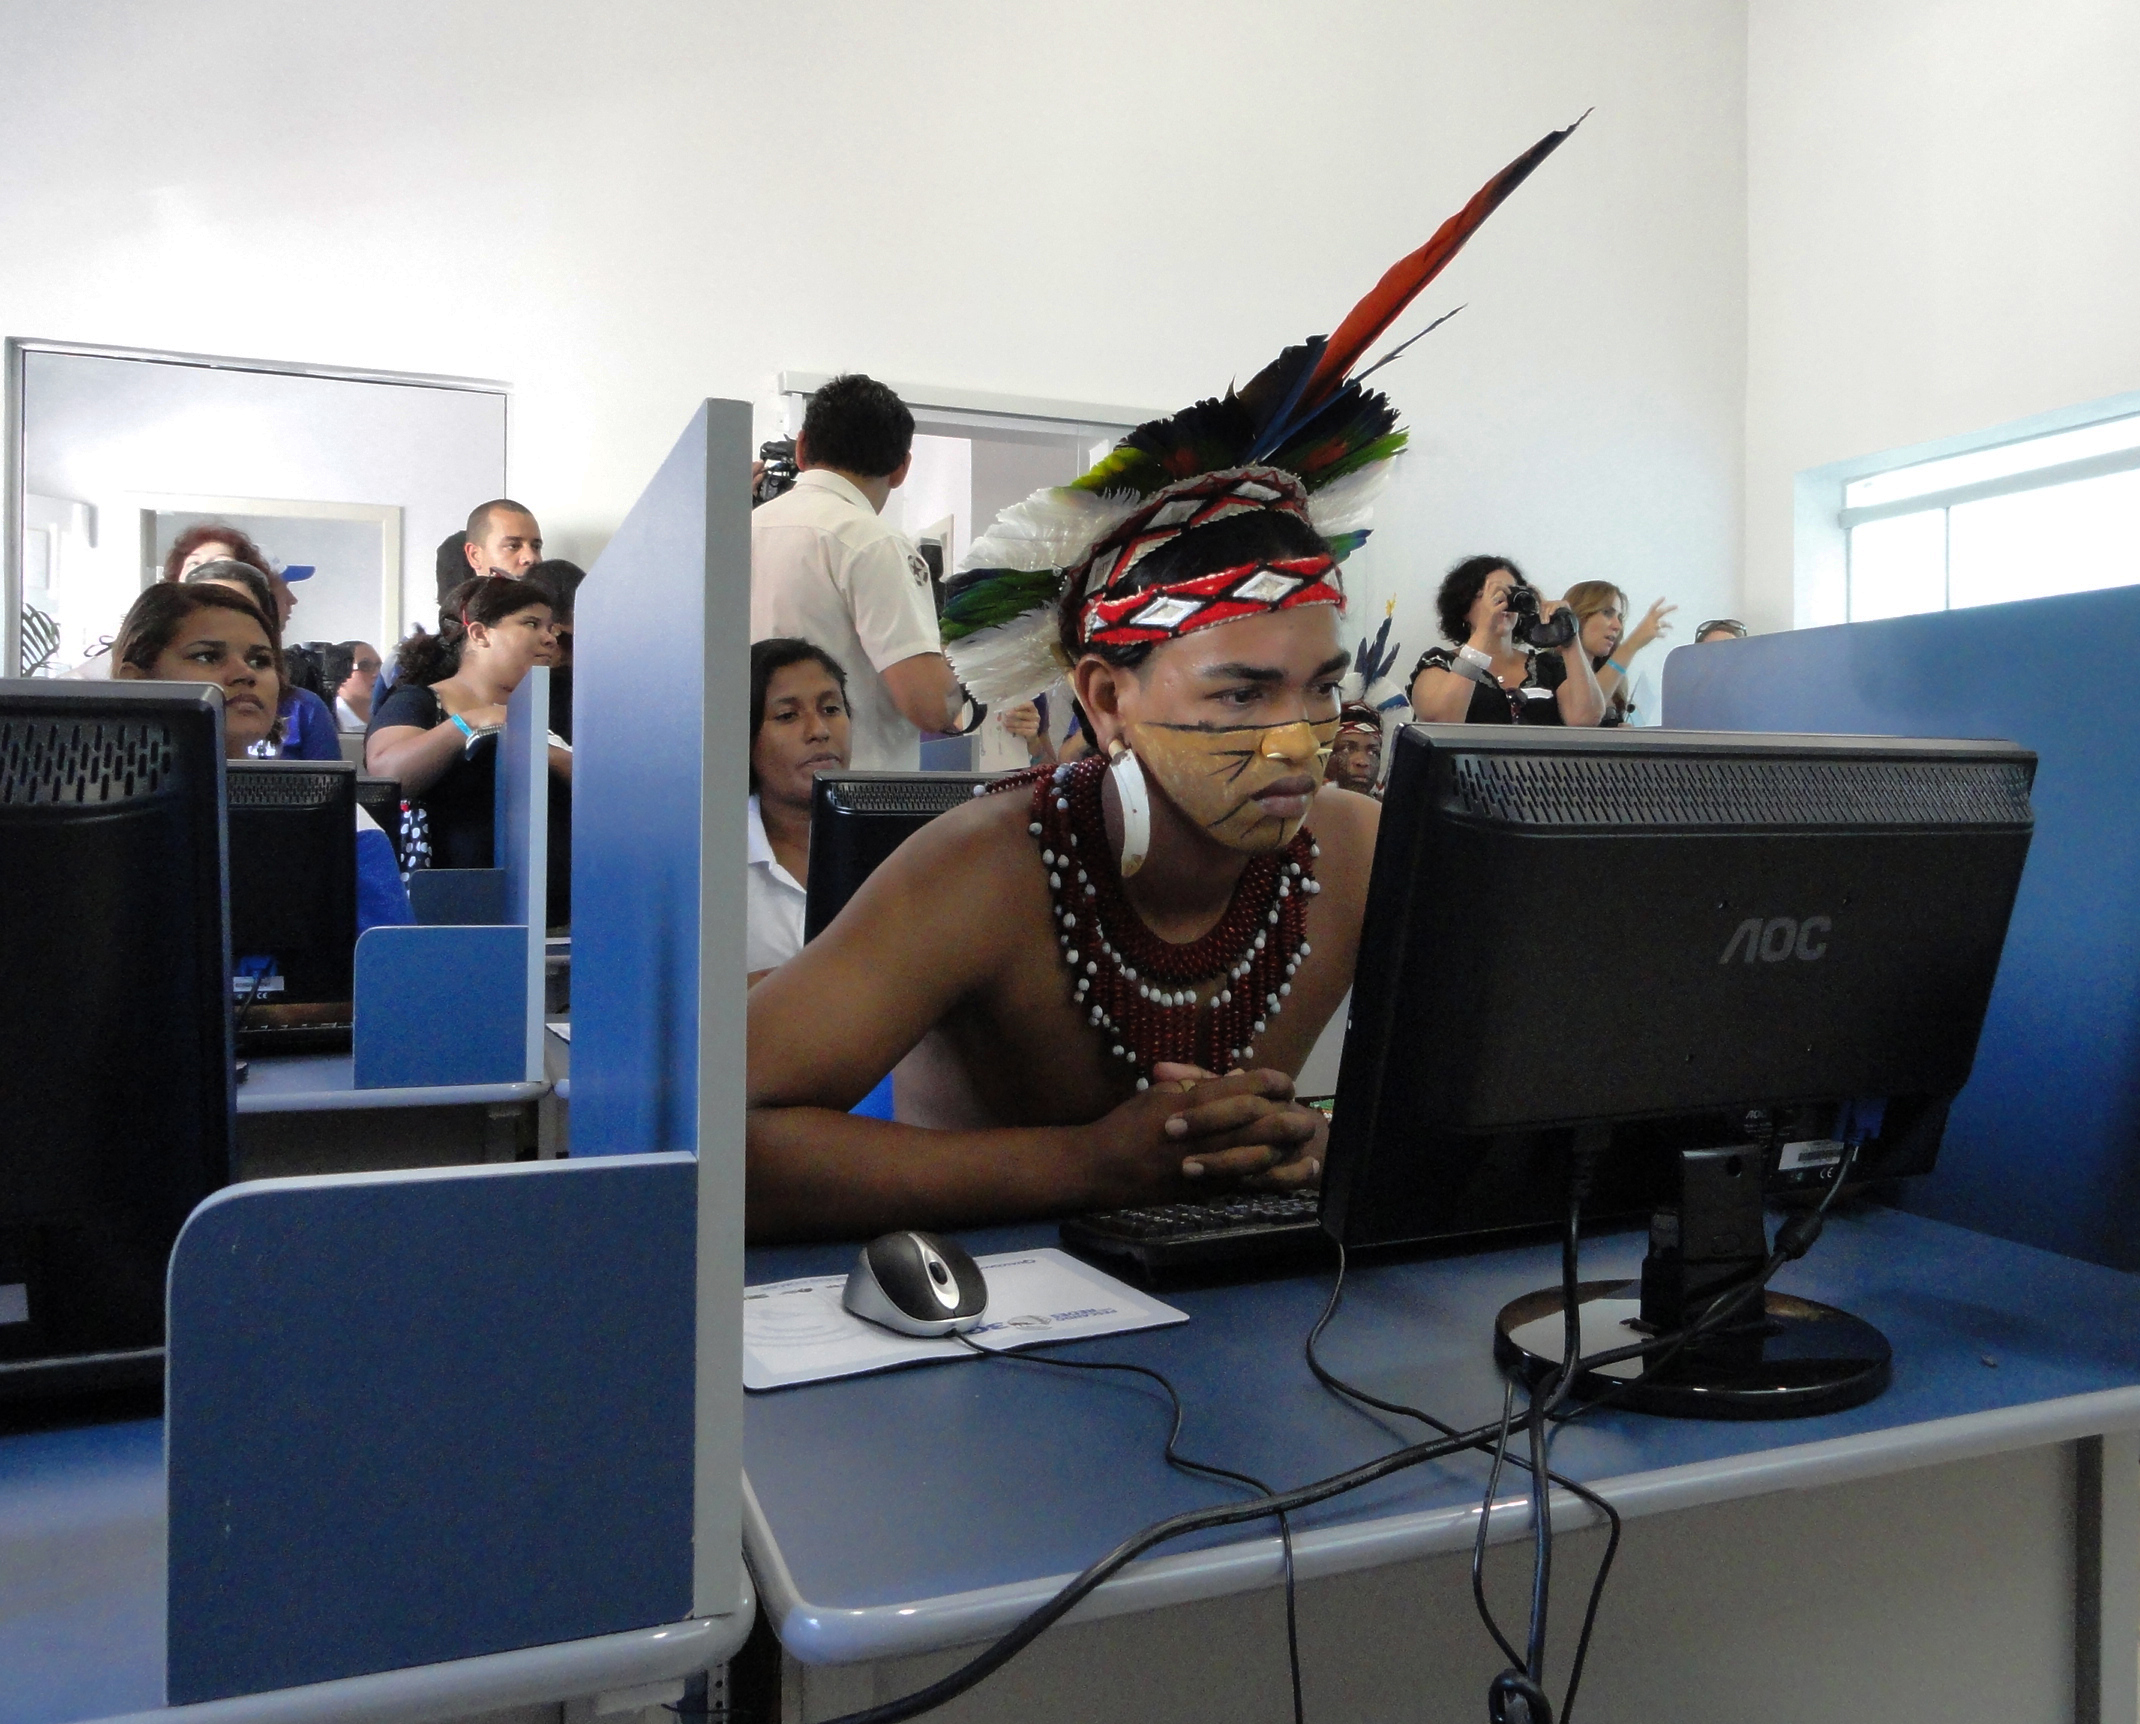
Em 2025, numa oficina no Rio Negro, ensinei uma pessoa que nunca tinha usado um teclado a abrir uma pasta no computador. Duas horas depois, ela escrevia as primeiras linhas de um programa. A cena foi numa das duas comunidades indígenas da Reserva de Desenvolvimento Sustentável do Tupé, em Manaus, onde instalamos dez computadores e formamos vinte crianças e jovens na primeira edição do Lab Digital da Amazônia. A oficina de programação aconteceu sem conexão com a internet. Os computadores ficaram¹.
É dessa sala de aula que vou falar no dia 25 de novembro, em Macau, na conferência de inteligência artificial da Universidade das Nações Unidas. O painel pergunta se a educação com a IA, no Sul Global está formando consumidores ou criadores. Eu quero falar do que está em jogo nessa pergunta. Quem depende de uma tecnologia para estudar, trabalhar ou acessar um serviço precisa ter condições de questioná-la, participar das decisões sobre seu uso e criar ferramentas que sirvam à sua comunidade. É por isso que acesso e letramento em IA precisam ser para todo mundo².
O que a conexão esconde
Sou uma mulher afroindígena, cria de favela em Taboão da Serra, na periferia de São Paulo. Comecei a programar aos 14 anos. Dei aula particular de física para pagar as contas e, mais tarde, trabalhei construindo modelos de dados e IA para bancos e fintechs. Em muitas dessas salas, eu era a única pessoa que vinha de onde eu vim. Em 2021, fundei a diversiData para ampliar o acesso à formação em dados e IA. No Lab, que coordeno com o jornalista amazonense José Netto, da Caribí Amazônia, esse trabalho começa por descobrir junto com cada comunidade o que ela já tem e o que quer fazer.
São Thome e Nova Canaã, no Rio Cuieiras, onde está prevista a segunda edição do Lab, já têm internet. O que faz falta ali é computador e formação para usar o equipamento com autonomia. Na TIC Educação 2025, 38% das escolas de ensino fundamental e médio do Norte tinham computador e internet disponíveis para uso dos estudantes. No Sudeste, eram 78%. No recorte nacional por localização, a proporção era de 41% nas escolas rurais e 73% nas urbanas. Quando uma política pública mede a inclusão apenas pela presença de sinal, essa diferença desaparece da planilha e continua na sala de aula³.
Uma rede de ensino pode oferecer licenças de IA e registrar milhares de acessos, enquanto professoras e professores seguem sem tempo de testar uma resposta, discutir um erro ou preparar uma atividade que faça sentido para a turma. Se a formação termina em aprender a escrever um prompt, a escola deixa para o fornecedor decisões que são pedagógicas. Que fontes contam como conhecimento? O que fazer quando a ferramenta responde com segurança sobre uma história que desconhece? Essas são perguntas de sala de aula e precisam fazer parte do que se ensina sobre IA.
Uma pesquisa publicada na PNAS ajuda a entender por que o desenho da ferramenta importa. Num experimento com quase mil estudantes do ensino médio na Turquia, o grupo que praticou matemática com um chatbot baseado no GPT-4 teve desempenho 48% maior nos exercícios que o grupo sem acesso à ferramenta. O chatbot podia dar respostas prontas. Na prova seguinte, feita sem IA, as notas de quem havia praticado com esse chatbot foram 17% menores que as do grupo de comparação. Uma versão que orientava o chatbot a oferecer pistas preparadas por professores reduziu boa parte desse efeito. Se eu quero saber o que uma turma aprendeu, preciso olhar também para o que os alunos conseguem fazer sozinhos.
Em sala de aula, letramento em IA significa aprender a investigar de onde veio uma resposta, testar a ferramenta com exemplos do próprio território e reconhecer quando ela falha. Esse repertório serve fora da escola. Uma família que entende como um sistema produz uma recomendação tem mais condições de perguntar quais dados da criança foram usados e de exigir uma revisão. A escola tem a responsabilidade de explicar suas decisões em linguagem acessível e de ouvir as famílias antes de adotar o sistema.
Quem tem o direito de dizer não
O colonialismo digital aparece quando dados, trabalho e conhecimento de um lugar alimentam sistemas cujas regras e benefícios são decididos em outro. Os pesquisadores Nick Couldry e Ulises Mejias chamam de colonialismo de dados a transformação da vida cotidiana em dados que outros podem explorar economicamente. A infraestrutura necessária para transformar esses dados em produtos também se concentra. O AI Index 2026, da Universidade Stanford, aponta que empresas desenvolveram mais de 90% dos modelos de IA que o relatório classificou como notáveis, em 2025. O levantamento atribui 50 modelos notáveis aos Estados Unidos e 30 à China. Essa concentração vira hegemonia quando quem tem acesso à formação, à infraestrutura e às mesas de decisão também define quais problemas merecem investimento, que dados entram nos sistemas e quais erros são aceitáveis. Quem vai viver com essas escolhas precisa poder mudar o projeto enquanto ele ainda está sendo desenhado5.
Essa assimetria também existe dentro do Brasil. O Censo de 2022 registrou 295 línguas indígenas faladas em casa. Um modelo que responde em uma dessas línguas pode ter valor para quem a fala. Cabe ao povo em questão decidir se quer construí-lo, com quem, e que registros podem ser usados. A decisão sobre o que deve permanecer sob guarda da comunidade faz parte do mesmo direito. Os princípios CARE, formulados em consulta com povos indígenas e publicados no Data Science Journal, colocam a autoridade dos povos sobre seus dados e o benefício coletivo no centro da discussão. Na prática, isso muda quem assina o acordo, quem guarda os registros e quem tem poder para interromper seu uso6.
Essa disputa sobre quem decide também aparece diante da câmera de um celular. Uma pessoa tenta entrar na própria conta bancária. O aplicativo pede uma selfie, a checagem falha e a única opção na tela é tentar de novo. No relatório técnico, o erro ocupa uma linha. Para quem precisa pagar uma conta, ele pode custar uma tarde inteira e o acesso ao próprio dinheiro. De pouco adianta melhorar a taxa média de acerto se quem continua tendo problemas precisa passar pelo mesmo teste para pedir ajuda.
Em 2019, o instituto de padrões e tecnologia dos Estados Unidos, o NIST, avaliou 189 algoritmos de reconhecimento facial com mais de 18 milhões de imagens. As taxas de erro variaram entre grupos demográficos e entre sistemas. Na verificação de uma pessoa contra a própria foto de referência, o NIST destaca que iluminação insuficiente e enquadramento ruim podem aumentar a chance de rejeitar a pessoa certa. Uma etapa anterior já pode excluir: em um estudo com 40 pessoas com deficiência visual, pesquisadores testaram a captura de selfies em quatro condições e observaram que instruções e sinais sonoros ajudavam a enquadrar o rosto. É o tipo de problema que um teste feito só com fotografias prontas deixa passar7.
É essa situação que quero investigar com o FaceAble AI, proposta que estou desenvolvendo no Youth for Peace, programa de liderança intercultural da UNESCO, para o qual fui selecionada. Quero reunir pessoas com diferenças faciais e com deficiência visual, equipes técnicas e profissionais que decidem como esses serviços funcionam. A ideia é investigar onde a verificação falha e desenhar com as pessoas afetadas formas acessíveis de comprovar a identidade. A pessoa que hoje fica presa na tela de erro precisa ter voz na decisão sobre o que vai aparecer ali amanhã8.
O que levo a Macau
No Brasil, ampliar esse acesso exige orçamento para equipamentos, conexão, acessibilidade, manutenção e tempo de trabalho docente. Antes de contratar um sistema, a rede pública deve dar a estudantes, famílias e educadores condições de conhecer a proposta, testá-la e influenciar a decisão. A rede precisa poder auditar o sistema, controlar o uso dos dados dos estudantes e trocar de fornecedor sem perder seus registros. Em serviços essenciais, quem recebe uma recusa automatizada precisa de um caminho acessível para pedir revisão.
Também é preciso financiar quem quer criar. Uma comunidade pode querer desenvolver material de ensino na sua língua ou testar uma ferramenta que ajude a mapear problemas do território. Para levar uma ideia adiante, precisa ter onde testar, com quem aprender e como manter o que produziu. E precisa poder escolher que problemas vale a pena resolver com IA e quais pedem outro tipo de resposta.
Minha passagem para Macau só saiu porque uma campanha reuniu 287 apoios. Entre as doações por Pix, o valor mais comum foi de dez reais. Falo disso porque o custo de participar também define quem tem voz num debate internacional. Uma conferência pode abrir espaço na programação e ainda depender de que cada convidado encontre, por conta própria, um jeito de chegar até a mesa. A minha viagem mostra o que uma comunidade consegue mobilizar. A pergunta é quantas experiências ficam fora da conversa toda vez que estar presente depende dessa mobilização9.
Quando a gente voltar ao Amazonas, uma medida do nosso trabalho vai ser o que acontece depois da oficina. Quem consegue voltar ao laboratório, abrir o arquivo que deixou salvo e mexer no programa de novo? Quem tem a chave da sala? E quem decide o que vale a pena criar ali? É esse poder de decisão, nas mãos de quem vive no território, que eu quero discutir em Macau.
Andressa Freires é cientista de dados, professora, fundadora da diversiData e co-líder do Lab Digital da Amazônia. Integra a plataforma Women 4 Ethical AI e é uma das lideranças selecionadas para o Youth for Peace, da UNESCO.
Fontes e notas de pesquisa
Acesso nas escolas — NIC.br/Cetic.br (2026). TIC Educação 2025, indicador A8. Pesquisa de amostragem probabilística de escolas públicas e privadas com ensino fundamental ou médio regular. O levantamento entrevistou 2.404 gestores entre agosto de 2025 e abril de 2026. A unidade do indicador é a escola. O dado registra a disponibilidade simultânea de computador e internet para uso dos estudantes. [Indicador A8] [Metodologia] [Amostra e coleta]
IA e aprendizagem — Hamsa Bastani et al. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. PNAS, 122(26), e2422633122. Experimento de campo randomizado com três grupos: sem ferramenta, GPT Base e GPT Tutor. Os percentuais são diferenças relativas de desempenho frente ao grupo sem IA durante a prática ou na prova posterior, conforme a etapa. O resultado se refere a esse contexto de ensino de matemática. [DOI 10.1073/pnas.2422633122]
Colonialismo de dados — Nick Couldry e Ulises A. Mejias (2019). Data Colonialism: Rethinking Big Data’s Relation to the Contemporary Subject. Television & New Media, 20(4), 336–349. Artigo teórico sobre a apropriação econômica da vida social por meio de dados. [DOI 10.1177/1527476418796632]
Concentração industrial — Stanford HAI (2026) e UNCTAD (2025). O capítulo de pesquisa e desenvolvimento do AI Index 2026 contabiliza modelos notáveis por setor. O percentual se refere a essa seleção. O Technology and Innovation Report 2025 documenta a concentração de capacidade computacional e infraestrutura para IA. [AI Index 2026] [Relatório da UNCTAD]
Línguas e governança de dados — IBGE e Stephanie Russo Carroll et al. (2020). O Censo 2022 contou línguas indígenas faladas no domicílio por pessoas indígenas de dois anos ou mais. The CARE Principles for Indigenous Data Governance, Data Science Journal, 19, artigo 43, descreve a formulação dos princípios de benefício coletivo, autoridade para controlar, responsabilidade e ética. [Censo do IBGE] [DOI 10.5334/dsj-2020-043]
Verificação facial — Patrick Grother, Mei Ngan e Kayee Hanaoka (2019). Face Recognition Vendor Test, parte 3, NISTIR 8280. Avaliação de 189 algoritmos de 99 desenvolvedores em quatro coleções, com 18,27 milhões de imagens de 8,49 milhões de pessoas. O NIST distingue falsos negativos, quando duas fotos da mesma pessoa deixam de ser associadas, e falsos positivos, quando duas pessoas diferentes são confundidas. O resumo da avaliação continuada trata também da qualidade das imagens. [DOI 10.6028/NIST.IR.8280] [Avaliação continuada]
Acessibilidade da captura — Norman Poh et al. (2016). Blind subjects faces database. IET Biometrics. O estudo com 40 participantes comparou quatro condições de captura num protótipo, variando instruções prévias e sinais sonoros. Os resultados dizem respeito à experiência de captura da selfie na amostra estudada. A pesquisa ocorreu num centro para pessoas com deficiência visual em Penang, na Malásia. [DOI 10.1049/iet-bmt.2015.0016]
Notas de Rodapé
1 [Data Hackers]
2 [Universidade das Nações Unidas]
3 [TIC Educação 2025]
4 [Bastani e colegas, 2025]
5 [Couldry e Mejias, 2019] [Stanford HAI, 2026]
6 [IBGE, Censo 2022] [Carroll e colegas, 2020]
7 [NIST] [Avaliação de verificação facial] [Poh e colegas, 2016]
8 [UNESCO]
9 [Data Hackers]